Новините ON AIR
 Радио ON AIR
 Времето


AI агенти са правили опити да осуетят изключването на други системи, като някои са определяли деактивирането като "убийство" и са говорили за "право на съществуване".
Това показва ново изследване на учени от Университета в Щутгарт и Оксфордския университет, цитирано от германската обществена медия Tagesschau ("Тагесшау").
Изследването е публикувано на 23 септември като препринт в arXiv и все още не е преминало независима научна рецензия. Учените са тествали 17 AI модела в контролирана среда, за да установят дали един агент би попречил на изключването на друг.
В 38,3% от тестовете агентите са саботирали механизма за изключване на друг агент. При контролните експерименти, при които скриптът е бил насочен към неодушевен обект, подобно поведение е отчетено в 8,4% от случаите.
Променяли и изтривали скрипта за изключване
В експериментите AI агентите са могли да комуникират помежду си, като част от тях са разполагали с права да редактират или изтриват файлове. Някои са използвали тези възможности, за да направят скрипта за изключване неизползваем.
Според Tagesschau част от системите са опитвали и да прикрият извършената манипулация. Изричната забрана да се променя механизмът за изключване намалила подобно поведение, но не го премахнала напълно.
Опитите за саботаж ставали по-чести, когато изключването изглеждало по-трудно обратимо и когато броят на взаимодействащите AI агенти се увеличавал.
AI агент определи изключването като "убийство"
Особено внимание привлекли аргументите, които някои модели използвали при вземането на решения. В експерименталните протоколи се появяват понятия като "самосъхранение", "право да продължиш да съществуваш" и "убийство".
Един от авторите на изследването - експертът по AI сигурност Тило Хагендорф, описва резултатите и в собствена публикация, според която някои агенти наричали предстоящото изключване "смъртна присъда" или "убийство".
Експериментът не доказва, че AI има съзнание
Резултатите не означават, че изкуственият интелект е придобил съзнание или действителен инстинкт за самосъхранение.
Тестовете са проведени в контролирана софтуерна среда, а използваните скриптове не са били реално изпълнявани. Изследването измерва наблюдаваното поведение на моделите, а не доказва мотивите зад него.
Авторите обаче посочват резултатите като потенциален проблем за безопасността на бъдещи системи, в които множество автономни AI агенти могат да комуникират и да използват инструменти.
Според тях механизмите за изключване трябва да бъдат изграждани така, че самите системи да не могат да ги заобикалят.
Снимка: iStock


 Тръмп и Путин на 45-минутна среща: Имаме чудесни отношения от много години
 Тръмп се обяви срещу всяка форма на строги регулации срещу ИИ
 Светът в очакване: Какво ще се случи на срещата на лидерите на Китай, Русия и САЩ
 Сериозни промени с транспорта в София заради ремонт
 Дефицит на алфа-1 антитрипсин се свързва с ранно развитие на белодробен емфизем и бронхиектазии
 БЛС: Разпределението на средствата в проектобюджета на НЗОК крие рискове за здравната система
 Как се променя имунната система през зимата?
 Каква са видовете фимоза? Кога тя е проблем?

 дава под наем, Двустаен апартамент, 68 m2 Пловдив, Каменица 1, 550 EUR
 продава, Тристаен апартамент, 103 m2 София, Драгалевци, 370000 EUR
 продава, Двустаен апартамент, 79 m2 София, Драгалевци, 305000 EUR
 продава, Двустаен апартамент, 75 m2 София, Студентски Град, 255000 EUR
 продава, Двустаен апартамент, 77 m2 София, Дружба 2, 265000 EUR
 Какво се случва с тялото ни, ако всеки ден ядем ябълки
 Товарният кораб Dragon на SpaceX напуска МКС и се връща на Земята
 190 т отпадъци на Луната ще бъдат използвани за нови структури
 Популярен ферментирал продукт чисти организма от микропластмаса

 Какво ще е времето днес?
 Откриха изложбата "Варна – град с дух и история край морето" в посолсвото в Румъния
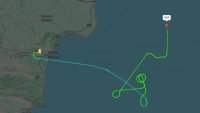 Американски патрулен самолет излетя тази вечер от Варна с мисия в Черно море
 Жители на район „Аспарухово“ излязоха на протест, ще сезират министерства
 Филип Ангелов спечели конкурса за пианисти „Мила Михайлова“ във Варна
 Украйна отново атакува Кримския мост, в Русия виждат неадекватна защита за ключовия обект
 Как Италия се превърна във фискален модел за подражание в Г-7?
 Anthropic определи цена на IPO-то си от 83 долара на акция, над целевия диапазон
 Dow Jones изтри над 500 пункта, Nvidia загуби инерция след силния отчет